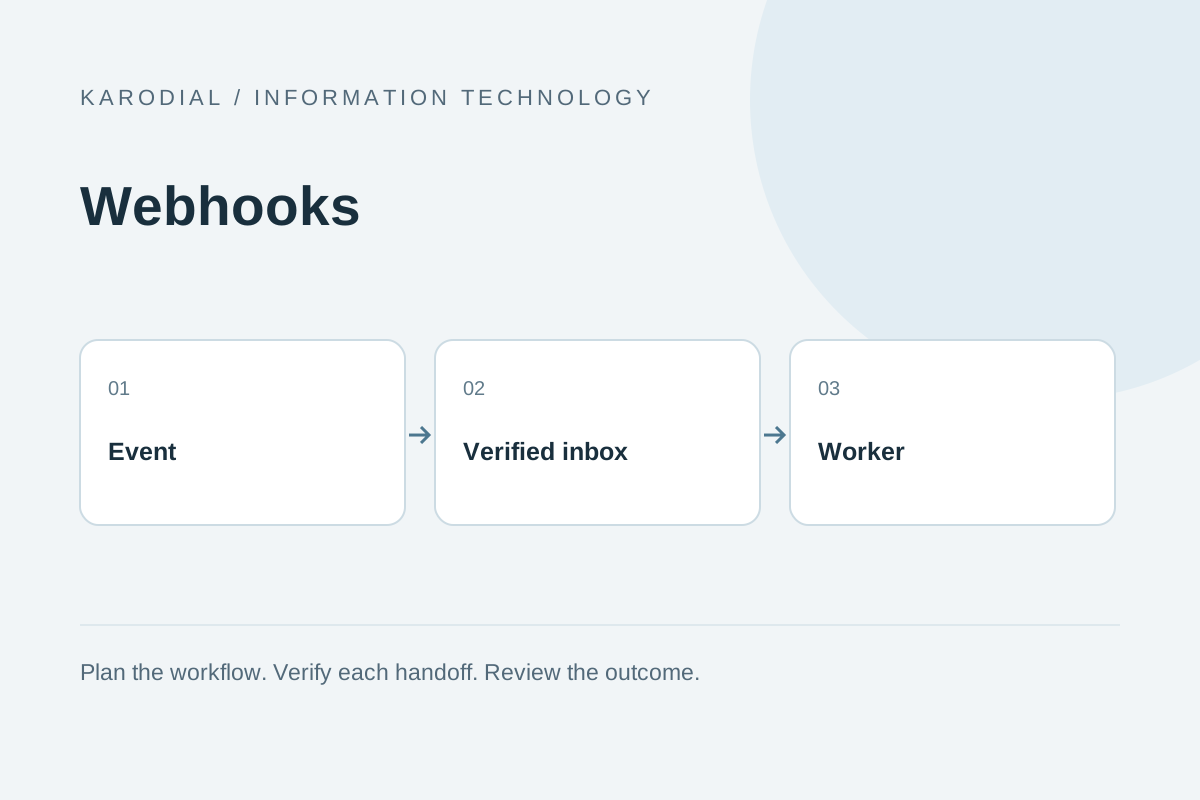
आपकी application किसी सेवा को संदेश भेजने का अनुरोध देती है। सेवा request स्वीकार करती है, लेकिन वास्तविक delivery बाद में होती है। अब परिणाम application तक कैसे आएगा? Webhook में provider आपके निर्धारित URL पर घटना की सूचना भेजता है। messaging, CRM और order processing जैसी प्रणालियों में यह तरीका उपयोगी है। इससे हर थोड़ी देर में status पूछने की जरूरत कम हो सकती है। लेकिन केवल callback URL बना देना पर्याप्त नहीं है। incoming event की पहचान, सुरक्षित storage, सही रिकॉर्ड से संबंध और repeated delivery को संभालना भी जरूरी है।
Webhook event क्या होता है?
Webhook सामान्य तौर पर किसी दूसरी प्रणाली में घटना होने पर भेजा गया HTTP request होता है। उसमें बताया जाता है कि क्या हुआ और कौन सा object प्रभावित हुआ। आपकी application उसे प्राप्त करने के लिए endpoint देती है। event नया message, बदला हुआ record या पूरा हुआ job बता सकता है। format और authentication हर provider के अनुसार अलग हो सकते हैं। इसलिए वास्तविक documentation पढ़ना जरूरी है।
इसका अंतर सामान्य status request से समझें। बार-बार पूछने की जगह provider सूचना देने की शुरुआत करता है। इसका मतलब यह नहीं कि हर event तुरंत और केवल एक बार आएगा। नेटवर्क की समस्या तथा provider की retry policy फिर भी लागू रहती है। हर status का अर्थ भी देखें। message delivered होने और ग्राहक द्वारा पढ़े जाने की सूचना अलग हो सकती है। event जितना प्रमाण देता है, उतना ही निष्कर्ष निकालें। अनुमान को confirmed result में बदलना आगे की automation गलत कर सकता है।
केवल उपयोगी events चुनें
ऐसी घटनाएँ subscribe करें जो कोई जरूरी निर्णय कराती हैं या परिणाम का प्रमाण देती हैं। सभी उपलब्ध events लेने से processing और monitoring जटिल हो सकती है। messaging में acceptance, delivery और failure काम के हो सकते हैं। CRM में enquiry assign होने की घटना कर्मचारी को सूचना दे सकती है। हर subscription का स्पष्ट उपयोग और जिम्मेदार व्यक्ति होना चाहिए।
implementation से पहले छोटी event map बनाएँ। event name, event ID, प्रभावित record, अपेक्षित बदलाव और exception owner लिखें। आवश्यक fields और version assumptions भी रखें। कोई payload आते ही बिना event type जाँचे बाहरी कार्रवाई शुरू न करें। पहले देखें कि वह आपकी किसी मौजूदा operation से संबंधित है या नहीं। उद्देश्य प्रक्रिया स्पष्ट करना है। छिपी automatic कार्रवाइयों की लंबी श्रृंखला बन जाने पर गलती खोजनी और ग्राहक को सही जानकारी देना दोनों कठिन हो सकते हैं।
receiving endpoint सीमित काम करे
स्थिर HTTPS endpoint रखें जो provider का request format समझता हो। उसे सामान्य user form से अलग रखना सुविधाजनक है। URL में secret न जोड़ें। request size की सीमा, method और content type जाँचें। provider जिस response की अपेक्षा करता है उसे सही status code के साथ भेजें। malformed या अस्वीकार्य request पर सफलता बताकर समस्या न छिपाएँ।
endpoint का काम छोटा और भरोसेमंद रखें। पहले authenticity जाँचें, फिर जरूरी envelope validate करके event durable storage या queue में रखें। भारी report, media processing और आगे के notifications worker कर सकता है। provider की response deadline पढ़ें; सभी सेवाओं के लिए एक ही समय सीमा मानना सही नहीं है। जल्दी response देना उपयोगी है, लेकिन तभी जब event वास्तव में recovery योग्य जगह पहुँच चुका हो। memory में थोड़ी देर रखने को सुरक्षित acceptance नहीं माना जा सकता।
signature जाँचकर sender पर भरोसा करें
कई providers shared secret या अन्य verification scheme से webhook sign करते हैं। उनकी documented प्रक्रिया का ठीक पालन करें। जाँच में original body bytes, headers, URL और timestamp की भूमिका हो सकती है। JSON parse करके फिर नया JSON बनाने से bytes बदल सकते हैं और सही signature भी असफल हो सकती है। valid तथा बदले हुए payload दोनों से परीक्षण करें।
secret server configuration में रखें और rotation का नियंत्रित तरीका बनाएँ। timestamp तथा replay protection उपलब्ध हों तो documented नियम लागू करें। अपनी ओर से ऐसा समय नियम न जोड़ें जो सही events को अस्वीकार कर दे। provider समर्थित IP ranges हों तो allowlist अतिरिक्त नियंत्रण हो सकती है, लेकिन आवश्यक signature verification की जगह अपने आप नहीं लेती। सिर्फ plausible ID वाला unauthenticated payload देखकर किसी संवेदनशील business operation को complete न करें। URL का कठिन या छिपा होना भी पर्याप्त authentication नहीं है।
event को सही operation से मिलाएँ
sender verified होने पर भी event को सही स्थानीय रिकॉर्ड से जोड़ना जरूरी है। provider operation ID और मूल request के saved relation का उपयोग करें। जरूरत हो तो संबंधित account या tenant भी जाँचें। यह संबंध स्थायी storage में हो ताकि worker restart होने पर न खोए। unknown event को किसी मिलते-जुलते ग्राहक से चुपचाप जोड़ने के बजाय समीक्षा के लिए दिखाएँ।
मान लें एक काल्पनिक appointment reminder भेजा गया। application स्थानीय reminder ID और provider message ID का संबंध सेव करती है। delivery event आने पर उसी संबंध से सही reminder बदलता है। केवल फोन नंबर key बनाना गलत हो सकता है, क्योंकि एक व्यक्ति को कई अलग messages जा सकते हैं। सही correlation एक event से दूसरी operation बदलने की गलती रोकता है। कर्मचारी को दिखाई देने वाला status भी उसी specific reminder का होना चाहिए, पूरी ग्राहक प्रोफाइल का अनुमानित परिणाम नहीं।
duplicate और अलग क्रम के events
provider को समय पर response न मिले तो वह फिर event भेज सकता है, भले आपने पहले वाला सेव कर लिया हो। durable event ID या उपयुक्त uniqueness rule से दोहरी processing रोकें। business update भी idempotent हो। वही delivery event दोबारा आने से नया message, दोहरा reward या दूसरी consequential action नहीं बननी चाहिए। केवल endpoint पर duplicate हटाना हमेशा पर्याप्त नहीं है।
event का arrival order भी निश्चित नहीं होता। देर से आया intermediate status confirmed final result को पीछे नहीं ले जाना चाहिए। हर operation के valid transitions लिखें। label के नाम या arrival time पर अंधा भरोसा न करें। कुछ workflows में बाद का correction वास्तविक हो सकता है, इसलिए underlying evidence और provenance रखें। सही नियम business contract और provider पर निर्भर करता है। अलग-अलग जगह बिखरी conditions की तुलना में स्पष्ट state model समझना और जाँचना अधिक आसान होता है।
acceptance और processing अलग रखें
incoming events को inbox table या durable queue में रखा जा सकता है। event पहचानने, संबंध जाँचने और समस्या समझने जितना जरूरी data सेव करें। payload access सीमित रखें और अनावश्यक private fields जमा न करें। worker बाद में event लागू करे और बताए कि processing सफल हुई, अस्थायी समस्या आई या समीक्षा चाहिए। retry की स्थिति और business status अलग रखें।
सफल response भेजने से पहले event durable होना चाहिए। यदि response के बाद process बंद हो गया और event केवल memory में था तो provider delivery पूरी मान सकता है, जबकि आपकी प्रणाली ने सूचना खो दी। दूसरी ओर बहुत धीमा endpoint अनावश्यक retries बना सकता है। संतुलन है जल्दी verification, सुरक्षित acceptance और उसके बाद सीमित background work। failure points लिखें ताकि recovery समझ सके कि event आया ही नहीं था या सेव होकर process नहीं हुआ। दोनों समस्याओं के समाधान अलग हैं।
सफलता के साथ failure भी जाँचें
provider के testing tools या नियंत्रित sample requests उपयोग करें। valid event, गलत signature, missing field, duplicate और अनजान event type चलाएँ। events उलटे क्रम में भेजकर देखें। event सेव होने के बाद worker fail कराएँ और फिर processing शुरू करें। सही business update केवल एक बार होना चाहिए। database उपलब्ध न होने की स्थिति भी परीक्षण में शामिल करें।
sample requests और logs साझा करते समय credentials हटाएँ। काल्पनिक recipients और isolated records रखें। response codes provider की retry policy से मेल खाते हैं या नहीं देखें। दूसरे account का event किसी अन्य ग्राहक का record न बदल सके। पूरा test chain महत्वपूर्ण है: event endpoint पर पहुँचे, storage में जाए, सही record बदले और कर्मचारी को सही परिणाम दिखे। केवल webhook URL पर request आने का screenshot operational correctness का पूरा प्रमाण नहीं देता।
monitoring और recovery का स्वामित्व
accepted events, processing delay, unknown IDs और repeated failures की निगरानी करें। alert ऐसी समस्या बताए जिस पर जिम्मेदार व्यक्ति कार्रवाई कर सके। payload retention तय करें और useful correlation सुरक्षित रखें। dashboard पर provider की delivery failure और अपने worker backlog का अंतर दिखना चाहिए। दोनों का कारण और समाधान समान नहीं है।
evidence गायब हो तो supported redelivery या reconciliation प्रक्रिया अपनाएँ। केवल समय बीतने से completion या failure घोषित न करें। reminder उदाहरण में भरोसेमंद प्रमाण मिलने तक unresolved स्थिति दिख सकती है। अधिकृत recovery से परिणाम स्थापित हो तो उसकी provenance रखें। event versions, verification और replay प्रक्रिया दस्तावेज़ करें। भरोसेमंद webhook व्यवस्था का पूरा क्रम है: प्राप्त करना, जाँचना, सेव करना, सही operation से जोड़ना, लागू करना और जरूरत पर recovery करना। callback URL इस पूरी जिम्मेदारी का पहला कदम है।